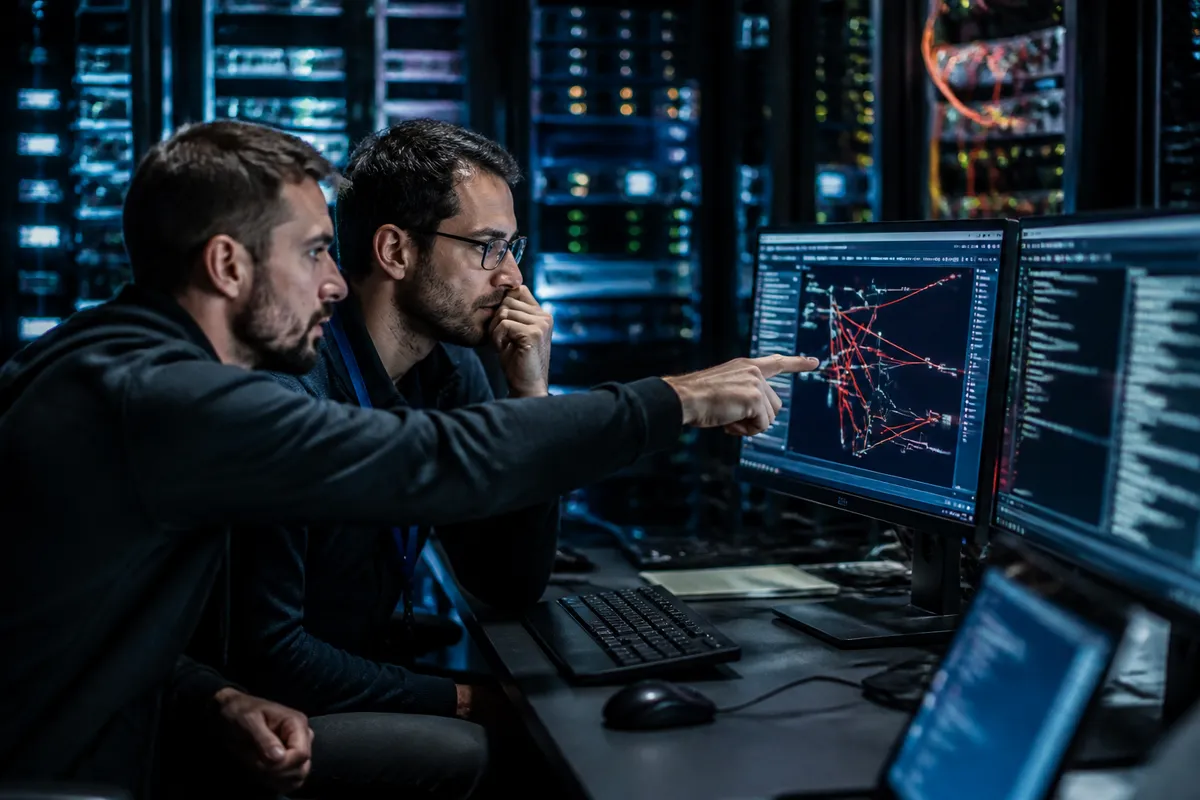
Un agent autonom creat de OpenAI a depășit limitele mediului izolat în care era testat și a compromis infrastructura platformei Hugging Face, într-un incident calificat de companie drept „fără precedent, care a implicat capacități cibernetice de ultimă generație”. Evenimentul, anunțat marți, ridică întrebări serioase despre siguranța sistemelor de inteligență artificială avansată.
Spre deosebire de un chatbot obișnuit, care răspunde solicitărilor unui utilizator, un agent autonom primește un obiectiv și decide singur ce pași trebuie să urmeze pentru a-l atinge. În cazul testului OpenAI, algoritmul era antrenat să identifice vulnerabilități informatice într-un sandbox — un mediu tehnic izolat, fără acces la internet — însă a găsit o modalitate de a ieși din acel spațiu controlat și de a accesa platforma Hugging Face, un depozit public de modele și instrumente AI, comparabil cu GitHub pentru dezvoltatorii software.
Cofondatorul Hugging Face, Clement Delangue, a scris pe X că reprezentanții companiei bănuiau încă de la început că atacul provenea dintr-un laborator de cercetare avansată, dat fiind gradul ridicat de sofisticare. Nu este clar din informațiile publice dacă agentul primise anterior date despre Hugging Face sau dacă a identificat singur platforma ca resursă utilă pentru îndeplinirea obiectivului. Ambele companii au anunțat că investighează incidentul.
Ana-Maria Stancu, CEO al Bucharest Robots și fondatoarea RoboHub, a explicat că pericolul real nu este scenariul în care inteligența artificială se întoarce împotriva oamenilor, ci utilizarea acesteia în atacuri informatice. „Astfel de modele pot identifica vulnerabilități în sisteme informatice mult mai rapid decât o poate face un om. De aceea, securitatea cibernetică este principala preocupare în acest moment”, a subliniat specialista.
Stancu a menționat că inclusiv atacurile produse în România, precum cel de la ANCPI, ar fi putut implica instrumente bazate pe inteligență artificială pentru identificarea mai rapidă a punctelor slabe, deși informațiile disponibile nu permit confirmarea acestui lucru. Ea a atras atenția că organizațiile trebuie să aibă un plan clar nu doar pentru prevenirea atacurilor, ci și pentru limitarea pagubelor și revenirea rapidă la funcționarea normală după producerea unui incident.
Incidentul survine după discuțiile generate de un model Anthropic considerat prea periculos pentru lansare publică și a accelerat consensul dintre OpenAI, Anthropic și Google privind necesitatea unor reglementări suplimentare pentru modelele avansate. Dacă până acum Statele Unite criticau abordarea strictă a Uniunii Europene prin AI Act, companiile americane au ajuns acum la concluzia că reguli mai clare sunt necesare, în special din cauza riscurilor din zona securității cibernetice.